デスクトップ型
NVIDIA
DGX Spark
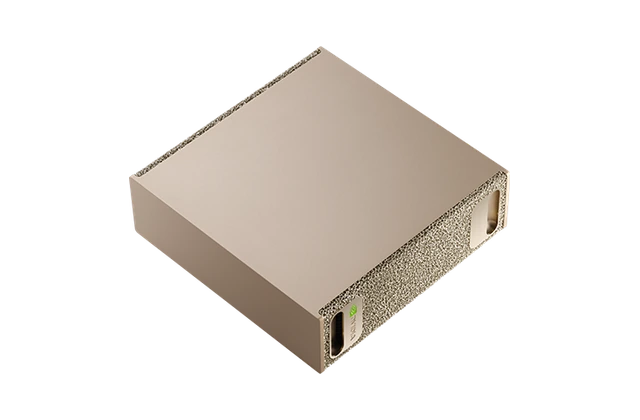
社内文書を検索するチャットは1台から検証できます。1台に収まらないモデルは、2台・4台のDGX Sparkに分割して推論できます。
- 統合メモリ(1台)
- 最大 128 GB
- スーパーチップ
- GB10 Grace Blackwell
128 GBモデルの合計メモリは、2台で256 GB、4台で512 GB。2台はケーブルで直結でき、4台は200 GbEスイッチ経由または4台を輪につなぐリング接続を選べます。
モデルの規模と利用人数に合わせて、
2つのDGXから構成を検討します。
NVIDIA
社内文書を検索するチャットは1台から検証できます。1台に収まらないモデルは、2台・4台のDGX Sparkに分割して推論できます。
128 GBモデルの合計メモリは、2台で256 GB、4台で512 GB。2台はケーブルで直結でき、4台は200 GbEスイッチ経由または4台を輪につなぐリング接続を選べます。
NVIDIA
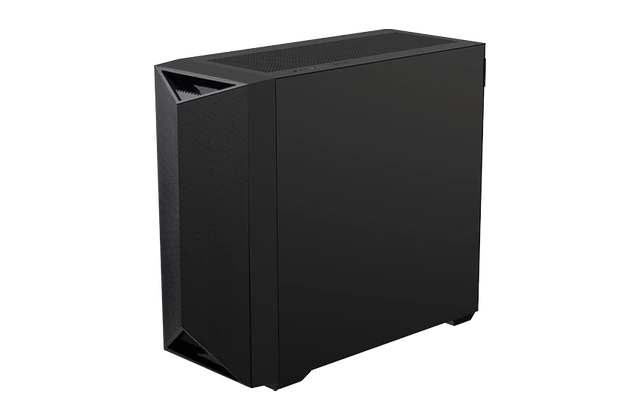
大規模モデルや複数人で使う推論環境に。長い入力や同時リクエストを想定した検証ができます。
DGX Stationの748 GBは、GPUメモリ252 GBとCPUメモリ496 GBの合計です。写真は PNY掲載のDGX Spark と、DGX Stationの搭載例 MSI XpertStation WS300 です。
重みが公開され、自社の機材で実行できるモデルを紹介します。
Tencent
画像付きの仕様書や作業動画の内容を質問できます。言語部分だけで770Bの大型モデルです。公式の配備例は8 GPUを使うため、複数GPUサーバーでの検証候補です。
Microsoft
日本語を含む8言語に対応した小型テキストモデル。長いメールから依頼事項を抜き出したり、下書きを短く書き直したりする処理を端末内で試せます。
Preferred Networks
53言語に対応する翻訳専用モデルです。製品名や専門用語の訳し方を用語集で指定し、前後の文脈を渡せます。公式の量子化版があり、商用利用には事前登録または個別契約が必要です。
Alibaba · Qwen
画面のスクリーンショットとコードを一緒に渡し、仕様との差分や修正案を検討できます。4ビット版はDGX Spark 1台から動作し、同じモデルを2台・4台で動かした速度も下の表で比較できます。
MiniMax
文章・画像・動画を入力でき、複数の手順にまたがる作業を扱います。NVIDIAは混合精度の量子化版を128 GBのDGX Spark 4台で動かし、コード課題での生成速度を測定しています。
DeepSeek
10月17日版はコード修正や視覚推論を改善した公開モデルです。大規模GPU環境向けで、NVIDIAの量子化版はGB300 GPU 4基で検証されています。
Meta
画像と文章を扱う816Bのモデルです。NVIDIAは4ビット版のコード生成をDGX Station 1台と2台で測定しています。元の重みの取得にはMetaの利用条件への同意とアクセス承認が必要です。
BENCHMARKS
DGXの台数による生成速度の違いと、業務の自動化やコード修正でのモデル別スコアを確認できます。
同じ入力に対して、モデルが文章を読み込む速度と回答を生成する速度を比較しています。
| 構成 | 入力処理 tok/s | 回答生成 tok/s |
|---|---|---|
| 1台 | 2,635 | 11.86 |
| 2台・直結 | 3,285 | 21.71 |
| 4台・リング接続 | 4,446 | 32.82 |
| 4台・スイッチ接続 | 4,556 | 36.34 |
NVIDIAが2026年10月22日に公開。Qwen3.8-27Bの4ビット版(NVFP4)を使用し、入力8,192トークン、出力256トークン、同時リクエスト1件で測定。先読み生成は無効、スイッチ接続はRoCEnanteを使用しています。
NVIDIAの測定結果・表2Metaの大規模モデルにコード課題を1件ずつ渡し、DGX Stationを1台で使う場合と2台を接続した場合の生成速度を比べています。
| 構成 | 回答生成 tok/s |
|---|---|
| DGX Station 1台 | 39.85 |
| DGX Station 2台 | 98.60 |
NVIDIAが2026年11月16日に測定。どちらもGB300、NVFP4、vLLM 0.34.0を使用。SPEED-Benchのコード課題を同時1件ずつ、出力上限8,192トークンで実行し、予備実行3件に続く10件を測定しました。
MiniMaxが公式モデルカードに掲載した、MiniMax M3.1 FlashとDeepSeek V4.1 Flash-1017の課題別スコアです。
| 課題 | MiniMax M3.1 Flash | DeepSeek V4.1 Flash-1017 |
|---|---|---|
| 業務の自動化Automation-Bench v1.0.6 | 62.8 | 60.5 |
| 端末での作業Terminal-Bench 4.0 | 38.1 | 42.3 |
| コード修正DeepSWE v1.1 | 73.7 | 77.0 |
スコアが高いほど、その課題での成績が高くなります。Automation-Benchは公開600課題、DeepSWEはコード修正課題です。実行ツールや入力の上限は評価ごとに異なります。
MiniMax公式の評価表ABCのサイバーセキュリティサービス「AI保守」では、お客様のサーバーログやエラーをABCの環境内で解析・保管します。
外部の生成AIにログを送らず、ローカルLLMが24時間365日、自動で異常の兆候を監視。確認が必要な事象を担当者に通知します。
サイバーセキュリティサービスを見る
ABC CYBERSECURITY
使いたい業務、扱うデータ、利用人数を伺い、必要な回答品質と応答時間を整理します。
候補となるモデルをDGX上で動かし、実際の業務に近い質問で回答内容と速度を確かめます。
検証結果をもとに構成を決定。利用者のアクセス方法や運用手順を整えます。
社内でAIを使いたい業務や、検討中の機材をお聞かせください。